教程补充说明
快速入门页直接展示作用、方法、API、输入和可运行示例;背景、兼容入口、安装和进阶用法集中在这里。
统一 DNA 入口与兼容对象
普通用户只需要记住一个核心对象:dnakit.DNA(...)。输入一条序列或多条序列、ID、拓扑、metadata 和 feature 都使用这个入口,返回类型始终是 DNA。
import dnakit

# 一条序列
dna = dnakit.DNA("ACGT")

# 一条序列,并附加信息
annotated = dnakit.DNA(
    "ACGT",
    id="seq-1",
    topology="circular",
    metadata={"species": "synthetic"},
    features=[{"type": "motif", "start": 1, "end": 3}],
)

# 多条序列,仍然返回 DNA
dataset = dnakit.DNA(["ACGT", "TTAA"])
detailed = dnakit.DNA(
    [
        {"sequence": "ACGT", "id": "seq-1"},
        {"sequence": "TTAA", "id": "seq-2", "topology": "circular"},
    ]
)

print(type(dna).__name__, type(dataset).__name__)
print(dataset.ids, dataset[0].symbols)
使用规则只有三条:字符串表示一条序列;字符串列表表示多条序列;多条序列需要不同附加信息时,用包含 sequence 的字典列表。data[0] 和 data[1:3] 仍返回 DNA。下面的 DNASequence、DNARecord 和 DNASet 是内部明确分层及旧代码兼容对象,普通使用不需要分别构造。
大文件、流式读取与高级索引
大文件参数与高级索引
- 普通用户: 使用同一个
dnakit.read(..., mode="stream")逐条读取,再把返回的数据流直接交给dnakit.write();只有需要固定分块时才使用iter_chunks()。
import dnakit

with dnakit.read("large.fa", mode="stream") as records:
    dnakit.write(records, "copy.fa")
- 高级用户: 需要按记录 ID 或坐标随机访问大型 FASTA/FASTQ 时,才使用索引接口;这些接口不是普通文件读取的必学入口。
- 高级 API:
dnakit.io.iter_chunks(values[必须], chunk_size[必须])、dnakit.io.build_fasta_index(source_path[必须], index_path[可选], overwrite[可选], max_records[可选], max_line_length[可选])、dnakit.io.load_fasta_index(index_path[必须], source_path[可选], verify_checksum[可选], max_index_bytes[可选])、dnakit.io.build_fastq_index(source_path[必须], index_path[可选], overwrite[可选], phred_offset[可选], max_records[可选], max_line_length[可选], max_record_bytes[可选], max_source_bytes[可选])、dnakit.io.load_fastq_index(index_path[必须], source_path[可选], verify_checksum[可选], max_index_bytes[可选], max_entries[可选])、dnakit.io.FastaIndex.fetch(record_id[必须], start[可选], end[可选], strand[可选], max_record_bytes[可选])、dnakit.io.FastqIndex.fetch(record_id[必须], start[可选], end[可选], strand[可选], max_record_bytes[可选])。
文件入口与兼容说明
读取和写入常见 DNA 序列、注释、表格及压缩文件。普通用户读取序列文件时只需记住 dnakit.read(),写出时只需记住 dnakit.write();文件较大时仍使用相同方法,仅将读取参数设为 mode="stream"。
大文件不是一种新的文件格式,也不需要新的普通读写入口。流式、分块和索引能力统一归入序列格式的大文件用法。
读取接口默认保留输入顺序。
理化性质模型与参考来源
1) 分子量
- 计算类型: 理论公式计算。
2) 260 nm 消光系数
-
计算类型: 经验参数计算。
-
计算口径: 对长度至少为 2 的序列,使用“所有相邻二核苷酸系数之和,减去所有内部单碱基系数之和”;单核苷酸直接使用其单碱基系数。参数表参考条件为 25 °C、pH 7,单位
M⁻¹·cm⁻¹,等价于L·mol⁻¹·cm⁻¹。ACGT的 40,300 结果与公开算例一致。 -
依据: IDT 的寡核苷酸定量说明、ACGT 公开算例与参数表、Warshaw–Tinoco 1966(DOI
10.1016/0022-2836(66)90115-X)和 Cantor–Warshaw–Shapiro 1970(DOI10.1002/bip.1970.360090909)。
3) 熔解温度Tm
- 计算类型: 经验模型估算。
4) 盐浓度修正
- 计算类型: 经验公式。
5) 局部熔解特征
- 计算类型: 滑动窗口计算。
6) 合成风险
- 计算类型: 确定性规则评分。
1) 热力学参数
- 计算类型: 热力学模型估算。
2) Nearest-neighbor
- 计算类型: 热力学模型估算。
3) Duplex stability
- 计算类型: 热力学模型估算。
4) 碱基堆积
- 计算类型: 参数表计算。
5) Hairpin
- 计算类型: Primer3 结构预测。
6) Self-dimer
- 计算类型: Primer3 结构预测。
7) Heterodimer
- 计算类型: Primer3 结构预测。
序列搜索术语
-
含义: motif 是 DNA 中具有某种特征的短序列模式,可以理解为 DNA 序列里的“关键词”。
-
含义: 起始密码子表示蛋白质翻译可能从这里开始,终止密码子表示蛋白质翻译到这里结束。
-
含义: 启动子是帮助基因开始转录的调控区域;启动子 motif 是其中常见的短序列特征,可以理解为基因转录的“启动标记”。
-
含义: TF motif 是转录因子偏好识别和结合的 DNA 序列模式,可能参与调节基因是否表达以及表达强弱。
-
含义: 限制酶位点是限制酶能够识别并切割的特定 DNA 序列,可以理解为“分子剪刀”的下刀位置。
-
含义: PAM 是紧邻 CRISPR 目标序列的短标记,Cas 蛋白通常需要先识别 PAM,才能结合并切割附近的 DNA。
-
含义: DNA 回文序列是与自身反向互补序列相同的片段,例如
GAATTC。 -
含义: 倒置重复是两段彼此反向互补、且中间可以隔着一段序列的 DNA 片段,可能折叠形成发卡结构。
-
含义: 串联重复是同一个短序列单元首尾相接、连续出现多次,例如
ATATAT是AT连续重复 3 次。 -
含义: 微卫星又称 STR,是重复单元长度为 1–6 bp 的短串联重复,例如
CACACACA。
绘图导出与依赖
将 DNA 序列、位置、比对、相似度矩阵以及 CSV 中的分类/回归样本分布绘制成可保存的图像。
输入 CSV、指定列名并绘制样本占比图,见下文 9) 分类与回归样本分布。
绘图函数返回确定性的正方形 SVGArtifact,图内不显示“DNA sequence”等装饰性标题;坐标、高亮标签、图例和碱基数等数据内容仍会保留。配置中的 title 仅用于 SVG 无障碍说明,不会绘制在图内。所有图形统一使用 save_image() 导出;image_type 可选择 png、svg 或 jpg,默认 png,目标路径没有扩展名时会自动补充。SVG 不需要额外图形依赖,PNG/JPG 需要安装 viz extra;原有 TIFF/PDF 导出继续兼容。下面每段示例都会把图像保存到当前工作目录,“示例结果”展示的是由相同代码生成的真实图像;保存函数默认拒绝覆盖已有文件。
样本分布:CSV、命令行与样式
9) 分类与回归样本分布
读取 CSV 中的一列或多列,为每列单独绘制样本占比图。柱高 = 该类别或区间内的样本数 ÷ 该列有效样本总数,纵轴以百分比显示,每张图的柱高之和为 100%(显示值四舍五入后可能略有偏差)。这是数据分布,不是模型对单个样本的预测置信度。
| 模式 | 输入列 | 柱子含义 |
|---|---|---|
classification |
0、1、2 等类别标签,也支持字符串 |
每个类别一根柱;类别数量自动扩展 |
regression |
连续数值 | 将数值分箱,每个区间一根柱;默认 30 个等宽区间 |
probability |
[0,1] 范围内的预测概率 |
使用数值分箱,额外拒绝越界概率;不对原始数值做归一化 |
概率列应显式选择 task="probability",CSV API 和 CLI(--task probability)同样支持。
例如 plot_distribution([0, 0.5, 1], task="probability", config=DistributionPlotConfig(bin_edges=[0, 0.5, 1]))
得到计数 [1, 2]。缺失值仍按有效样本数统计;NaN/Inf 和越界值拒绝。
普通 regression 继续允许负数;范围检查无法识别恰好落在 [0,1] 内的 logits,因此还需选择正确列。
CSV 示例与统计规则
完整的 示例 CSV 位于仓库的 docs/assets/data/distribution.csv,包含 200 条人工生成的演示数据:label 列的 0、1、2 类分别有 40、100、60 条;score、score_alt 是连续数值。CSV 首行必须是列名,绘图时按列名精确选择。
- 每列独立统计,互不混合;多列在一次调用中使用相同模式和样式,分类与回归混合时分别调用。
- 空单元格、纯空白字符串和 Python 输入中的
None跳过;缺失数量记录在结果中,CLI 也会报告。整列为空时报错。 - 回归的非数字、
NaN、inf报错,不自动当作缺失值;分类保留标签文本,0与0.0是不同类别,首尾空白会去除。 - 分类默认按类别首次出现顺序排列,可指定顺序并增加未出现的类别,后者占比为 0%;指定类别必须包含全部已观察到的类别。
- 回归区间为左闭右开
[a, b),最后一个区间包含右端点。常数列自动画一个占比 100% 的区间。 - 自定义分箱边界必须严格递增并覆盖全部有效数值,超出范围时报错;即使区间不等宽,柱高仍是样本占比,不是概率密度。
- 默认最多读取 1,000,000 行、绘制 1,000 个类别/区间,超限时报错,不截断统计。刻度过多时会减少文字标签,所有柱子仍保留。
命令行:分类占比
在项目根目录、已安装 DNAKit 的环境中执行。若尚未安装,先运行 python -m pip install -e ".[viz]";SVG 导出仅需基础安装,PNG/JPG/PDF 等使用 viz 依赖。
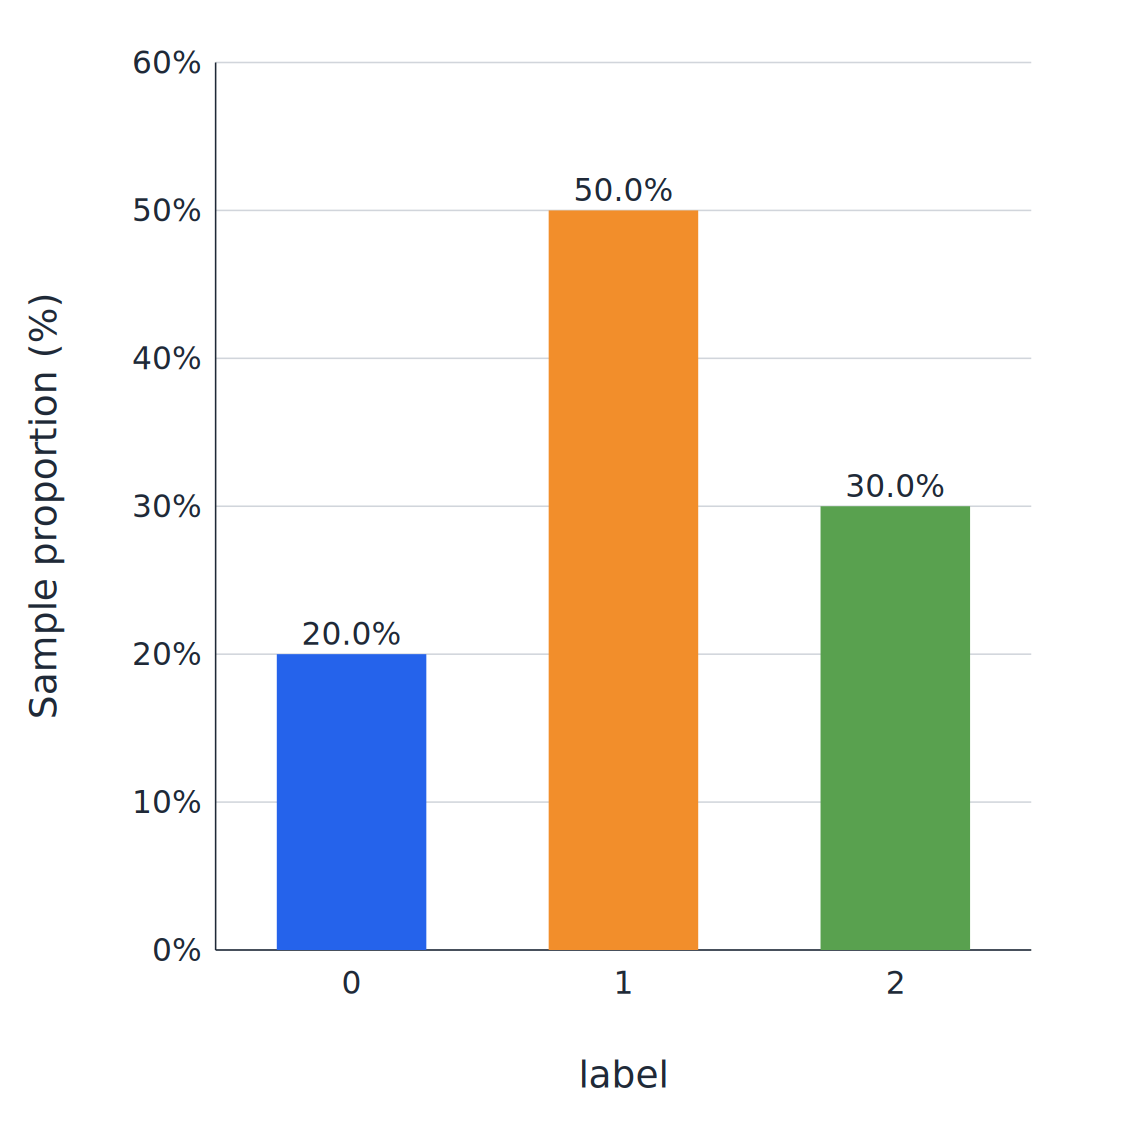
作用:统计 label 列的类别占比,按 0、1、2 排列,柱上显示百分比,并保存为 PNG。
python -m dnakit.cli plot-distribution \
  --input docs/assets/data/distribution.csv \
  --column label \
  --task classification \
  --output outputs/label_distribution.png \
  --category 0 \
  --category 1 \
  --category 2 \
  --show-values \
  --dpi 150
示例结果:三根柱分别为 20%、50%、30%。
命令行:回归数值分布
作用:对 score 列按 30 个等宽区间统计占比,使用默认多色柱子保存为 PNG。
python -m dnakit.cli plot-distribution \
  --input docs/assets/data/distribution.csv \
  --column score \
  --task regression \
  --output outputs/score_distribution.png \
  --bins 30 \
  --dpi 150
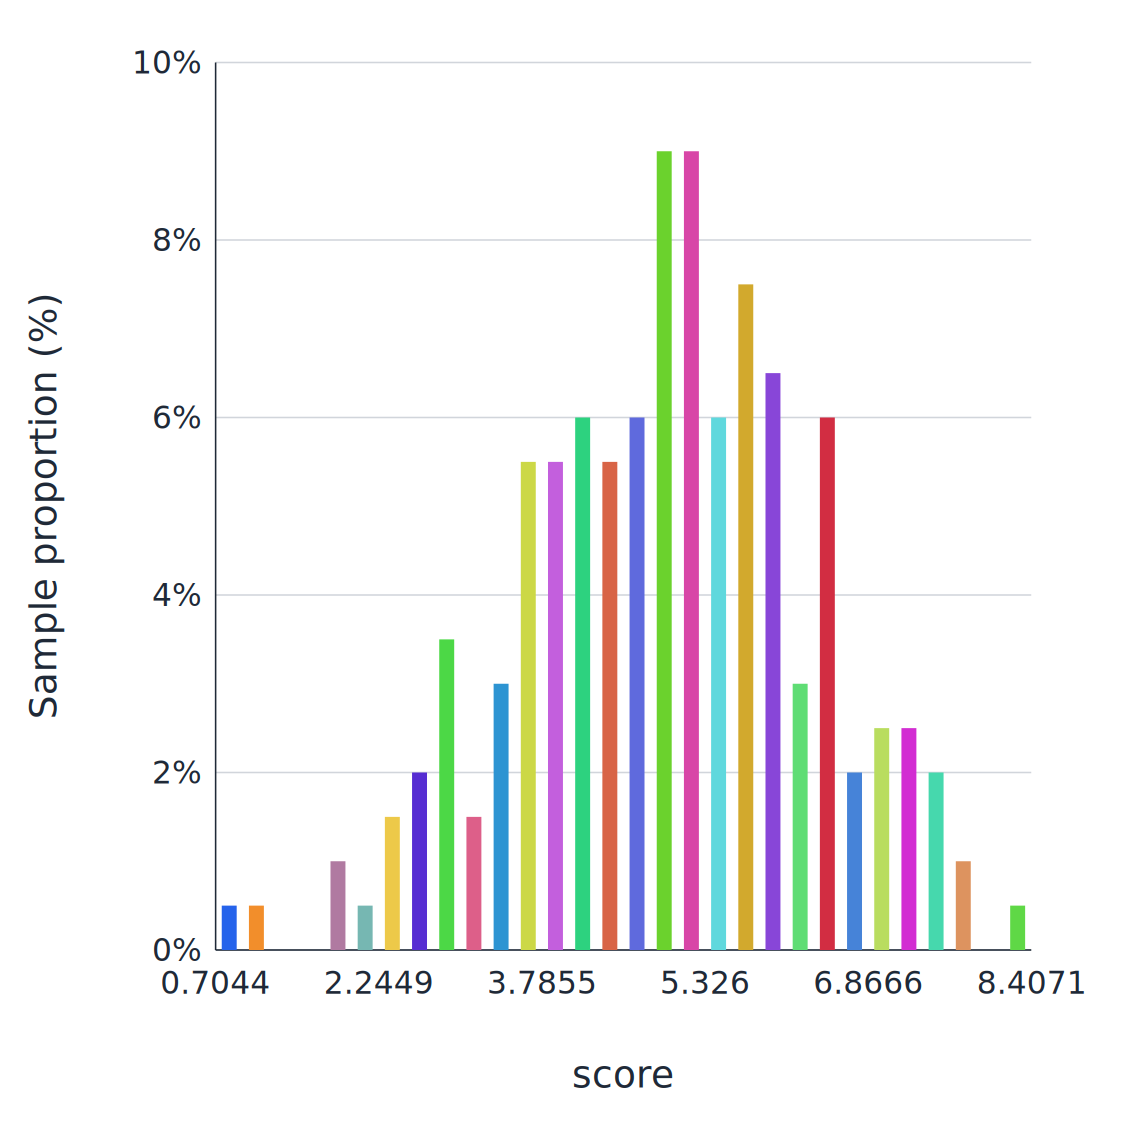
作用:一次读取两列,各自统计并保存为指定的 SVG 文件。--column 与 --output 按出现顺序一一对应。
python -m dnakit.cli plot-distribution \
  --input docs/assets/data/distribution.csv \
  --column score \
  --column score_alt \
  --task regression \
  --output outputs/score.svg \
  --output outputs/score_alt.svg \
  --bins 25
自定义区间时使用 --bin-edges '0,2,4,6,8,10',优先于 --bins。边界从负数开始时使用 --bin-edges=-10,-5,0,5,10,15,避免被命令行解析为选项。示例两列分别自动确定范围;要比较相同区间,应提供共同的 --bin-edges。
Python API 与样式
默认每根柱子使用不同颜色,柱宽为类别槽/分箱宽度的 55%;轴标题字号为 24,刻度和柱顶占比字号为 20,字体为 sans-serif。自动配色按显示顺序确定,类别较多时自动扩展;显式指定 categories 可固定类别顺序。分类柱状图与回归直方图均使用这些默认值,无需在脚本中重复设置。
自定义配色使用 DistributionPlotConfig(bar_colors=("#2563eb", "#f28e2b"));颜色少于柱子时循环使用。CLI 对应 --bar-color "#2563eb" --bar-color "#f28e2b",与统一单色的 --color 互斥。
plot_csv_distributions(source, columns=..., task=..., config=...) 返回 {列名: SVGArtifact};已经有列表时,可调用 plot_distribution(values, task=..., config=...)。使用既有 save_image() 指定文件名和格式。
from dnakit.visualization import (
    DistributionPlotConfig,
    ImageExportConfig,
    plot_csv_distributions,
    save_image,
)

plots = plot_csv_distributions(
    "docs/assets/data/distribution.csv",
    columns=["label"],
    task="classification",
    config=DistributionPlotConfig(
        categories=("0", "1", "2", "3"),  # 未出现的第 3 类占比为 0%
        size=800,
        show_values=True,
        x_label="Class",
    ),
)
artifact = plots["label"]
print(artifact.metadata["counts"])       # (40, 100, 60, 0)
print(artifact.metadata["proportions"])  # (0.2, 0.5, 0.3, 0.0)
save_image(
    artifact,
    "outputs/custom_distribution.png",
    config=ImageExportConfig(dpi=150, create_parents=True),
)
| 配置/CLI 参数 | 默认值 | 作用 |
|---|---|---|
bins / --bins |
30 |
回归等宽分箱数量 |
bin_edges / --bin-edges |
None |
回归自定义边界,覆盖 bins |
categories / 重复 --category |
None |
类别显示顺序及可选的零计数类别 |
size / --size |
720 |
正方形 SVG 画布边长,至少 320 |
font_size / --font-size |
24 |
坐标轴名称字号 |
tick_font_size / --tick-font-size |
20 |
坐标刻度字号 |
value_font_size / --value-font-size |
20 |
柱顶占比字号 |
theme.font_family / --font-family |
sans-serif |
字体名称,需系统已安装;中文可使用 Noto Sans CJK SC |
theme.accent |
#2563eb |
自动配色时第一根柱子的颜色,其余柱子自动分配不同颜色 |
bar_colors / 重复 --bar-color |
None(自动多色) |
自定义颜色序列,按顺序循环;统一单色可用 bar_colors=("#2563eb",) 或 CLI --color "#2563eb" |
theme.background / --background |
#ffffff |
背景颜色;API 的 SVGTheme 还可设置文字、网格颜色 |
bar_width / --bar-width |
0.55 |
柱宽占类别槽或分箱宽度的比例,1 表示无间隙 |
label_rotation / --label-rotation |
0 |
横轴刻度旋转角度,可选 0、45、90 |
max_tick_labels / --max-tick-labels |
12 |
控制横轴标签密度;回归根据字号减少重叠刻度,并保留最右边界 |
show_values / --show-values |
False |
显示柱顶占比;密集直方图建议保持关闭 |
show_grid / --grid、--no-grid |
True |
显示水平网格 |
x_label / --x-label |
CSV 列名 | 横轴名称 |
y_label / --y-label |
Sample proportion (%) |
纵轴名称;数据始终按占比计算 |
ImageExportConfig.dpi / --dpi |
600 |
位图导出分辨率;默认像素边长约为 size × dpi / 96 |
encoding / --encoding |
utf-8-sig |
CSV 编码,默认兼容 UTF-8 BOM |
delimiter / --delimiter |
, |
CSV 单字符分隔符 |
max_values / --max-values |
1000000 |
输入样本行数上限,包含空值行 |
输出支持 PNG、SVG、JPG、TIFF、PDF;没有扩展名时默认补 .png。CLI 自动创建输出父目录,默认拒绝覆盖,重复执行同一路径时可加 --overwrite。与现有可视化保持一致,title 仅是 SVG 无障碍说明,不在图内绘制标题。
神经网络模型与 checkpoint
5.2 支持的 11 种神经网络的 rep
以下 model 名称直接来自当前 MODEL_REGISTRY:
| 序号 | model |
rep 来源 | 默认官方 checkpoint | 加载条件 |
|---|---|---|---|---|
| 1 | alphagenome |
AlphaGenome all folds | google/alphagenome-all-folds | 须接受模型条款并安装官方 research 代码 |
| 2 | caduceus |
Caduceus-Ph 131k | kuleshov-group/caduceus-ph 131k | neural、neural-caduceus extras;须显式 allow_remote_code=True |
| 3 | dnabert2 |
DNABERT-2-117M | zhihan1996/DNABERT-2-117M | neural extra;须显式 allow_remote_code=True |
| 4 | enformer |
Enformer PyTorch | EleutherAI/enformer-official-rough | neural、neural-enformer extras |
| 5 | evo2 |
Evo 2 7B | arcinstitute/evo2_7b | neural、neural-evo2 extras;需兼容 GPU 环境 |
| 6 | generator |
GENERator v2 eukaryote 1.2B | GenerTeam/GENERator-v2-eukaryote-1.2b-base | neural extra;须显式 allow_remote_code=True |
| 7 | grover |
GROVER | PoetschLab/GROVER | neural extra;已完成真实 checkpoint rep + k-means smoke |
| 8 | hyenadna |
HyenaDNA medium 450k | LongSafari/hyenadna-medium-450k-seqlen-hf | neural extra;须显式 allow_remote_code=True |
| 9 | janusdna |
JanusDNA 131k | Harvard Dataverse DOI 10.7910/DVN/HDT0RN | checkpoint 校验官方 MD5;还须提供官方源码及 model_source_path |
| 10 | lucaone(默认) |
LucaOne gene step 36.8M | LucaGroup/LucaOne-gene-step36.8M | neural extra;须显式 allow_remote_code=True |
| 11 | ntv2 |
Nucleotide Transformer v2 500M multi-species | InstaDeepAI/nucleotide-transformer-v2-500m-multi-species | neural extra;须显式 allow_remote_code=True |
查询当前注册的全部模型,不会下载 checkpoint:
('alphagenome', 'caduceus', 'dnabert2', 'enformer', 'evo2', 'generator', 'grover', 'hyenadna', 'janusdna', 'lucaone', 'ntv2')
表征缓存与加载
默认 checkpoint 下载到当前工作目录的 ckpt/lucaone-gene-step36-8m/,已有完整文件时直接复用。下载和逐序列提取默认显示进度条;可用 checkpoint_dir、checkpoint_path 或 show_progress 显式调整。
神经网络聚类:checkpoint 与配置
默认模型是 lucaone,对应 checkpoint
LucaGroup/LucaOne-gene-step36.8M。首次调用默认下载到运行命令所在目录的
ckpt/lucaone-gene-step36-8m/;完整 checkpoint 已存在时直接复用,不重复下载。
每个目录会保存 .dnakit-checkpoint.json 来源清单。可用 checkpoint_dir 修改缓存
根目录,或用 checkpoint_path 指向现有 checkpoint 目录并完全跳过下载。下载和
逐序列提取默认显示进度条。
LucaOne checkpoint 包含自定义 Transformers 代码。DNAKit 不会隐式执行它;使用
默认模型的标准后端时,仍须在 RepresentationConfig 中显式设置
allow_remote_code=True。
只提取 rep:
from dnakit.representations import RepresentationConfig, extract_representations

reps = extract_representations(
    records,
    config=RepresentationConfig(allow_remote_code=True),
)
print(reps.representations.shape)
可选模型与官方 checkpoint
model |
默认官方 checkpoint | 加载条件 |
|---|---|---|
grover |
PoetschLab/GROVER | neural extra;本地独立模型环境已完成真实 checkpoint 的 rep + k-means smoke |
dnabert2 |
zhihan1996/DNABERT-2-117M | neural extra;需显式 allow_remote_code=True |
ntv2 |
InstaDeepAI/nucleotide-transformer-v2-500m-multi-species | neural extra;需显式 allow_remote_code=True |
hyenadna |
LongSafari/hyenadna-medium-450k-seqlen-hf | neural extra;需显式 allow_remote_code=True |
caduceus |
kuleshov-group/caduceus-ph 131k | neural、neural-caduceus extras;需显式 allow_remote_code=True |
lucaone(默认) |
LucaGroup/LucaOne-gene-step36.8M | neural extra;需显式 allow_remote_code=True |
generator |
GenerTeam/GENERator-v2-eukaryote-1.2b-base | neural extra;需显式 allow_remote_code=True |
enformer |
EleutherAI/enformer-official-rough | neural、neural-enformer extras |
alphagenome |
google/alphagenome-all-folds | 须接受模型条款并安装官方 research 代码;硬件和 JAX/Orbax 环境要求高 |
janusdna |
Harvard Dataverse DOI 10.7910/DVN/HDT0RN | checkpoint 自动校验官方 MD5;还须取得官方源码并设置 model_source_path |
evo2 |
arcinstitute/evo2_7b | neural、neural-evo2 extras;遵循官方 Evo 2 环境和 GPU 要求 |
除 GROVER 真实 smoke 外,其余模型在本功能中已完成注册、checkpoint 解析及对应
adapter 接入,但尚未在同一台机器上逐个完成全 checkpoint 数值验证。因此
神经网络聚类状态为 conditional,不能把“已接入”解释为所有模型、硬件和版本均
已验证。
远程代码边界: 表中注明的模型会从 checkpoint 加载 Python 代码。DNAKit
默认拒绝这类执行,只有调用方审查官方仓库和 checkpoint 后显式设置
allow_remote_code=True 才加载。checkpoint 不随 wheel/sdist 分发;模型许可、
访问条款、显存和存储需求均由使用者另行确认。
结果: NeuralClusteringResult 保存 labels、cluster 成员、中心最近代表序列、
模型名、checkpoint 路径、原始/聚类维数、inertia、可计算时的 silhouette、PCA
解释方差、seed 和实际迭代数。
切分入口、FASTA/BED 与结果元数据
序列切分
作用: 按固定窗口、重叠滑窗、随机区间或多尺度策略把长 DNA 切成带来源坐标的片段,并以迭代器逐条返回,用于模型输入、分区分析和大序列流式处理。
按照固定长度、滑动窗口、随机区间或多尺度策略切分 DNA 序列,从而生成带坐标的序列片段。
所有切分都使用 0-based、半开区间坐标,并惰性返回 SequenceChunk,不会一次性把全部结果读入内存。
序列切分总览
API 入口如下:
dnakit.iter_sequence_chunks(value[必须], config[可选], start[可选], end[可选], source_id[可选], split[可选], region_index[可选], progress[可选]):切分单条DNASequence或DNARecord;dnakit.iter_fasta_chunks(source[必须], config[可选], bed[可选], read_config[可选], progress[可选]):逐条读取并切分 FASTA;dnakit.ChunkingConfig(strategy[可选], length[可选], step[可选], min_length[可选], max_length[可选], num_samples[可选], lengths[可选], steps[可选], stage_steps[可选], include_partial[可选], seed[可选], split[可选], allow_gaps[可选]):定义切分策略;dnakit.make_length_curriculum(lengths[必须], stage_steps[可选]):创建先短后长的长度训练计划;dnakit.LengthCurriculum.to_config(window_step[可选], include_partial[可选], seed[可选], split[可选], allow_gaps[可选]):把长度计划转换为切分配置;dnakit.SequenceChunk.to_record():把切分结果转换为DNARecord,无调用参数。
所有策略都返回惰性的 SequenceChunk,并保留来源 ID、起止坐标、split、策略和尺度编号等 provenance 信息。
FASTA、BED 与结果元数据
iter_sequence_chunks() 用于切分单条 DNASequence 或 DNARecord;iter_fasta_chunks() 用于逐条读取并切分 FASTA。
不传 bed 时,所有 FASTA 记录默认使用 train 标签;传入 BED 时,要求 BED 第 1 列与 FASTA ID 完全相同,第 4 列可使用 train、valid、test 等标签。
每个 SequenceChunk 包含 source_id、source_start、source_end、split、strategy 和 level_index。调用 to_record() 后,来源 ID、起止坐标、split 和尺度编号会写入记录 metadata。
传入 progress=callback 可接收 started、yielded、completed 事件。当前 FASTA 读取器一次保留一条 FASTA 记录;处理染色体级大记录时,请根据实际内存调整 ReadConfig 的输入限制。
序列生成:扩展算法与结果元数据
1. 突变生成
- 作用: 对序列中的每个碱基独立判断是否发生替换突变。
- API:
dnakit.ops.evolution_generate(sequence[必须], augmentations=("mutation",), seed/rng[二选一], mut_frac[可选])。 - 概率:
mut_frac表示每个碱基发生突变的概率,范围为0.0~1.0,默认值为0.05。命中的碱基会等概率替换为另外三种 canonical 碱基之一,因此一定会改变。 - 补充:
mutate()用于指定位置或随机位置的单次单碱基替换,不接收概率参数。
2. 插入生成
- 作用: 对序列中的每个碱基独立判断是否在其后插入随机 DNA。
- API:
dnakit.ops.evolution_generate(sequence[必须], augmentations=("insertion",), seed/rng[二选一], insert_frac[可选], insert_min[可选], insert_max[可选])。 - 概率:
insert_frac表示每个碱基位置发生插入的概率,范围为0.0~1.0,默认值为0.05。 - 插入长度:
insert_min=1, insert_max=1时,每次命中只插入 1 个随机碱基;设置其他最小值和最大值时,每次命中会在闭区间[insert_min, insert_max]内随机选择片段长度。
如果只想在整条序列中随机选择一个位置,并插入一次连续片段,可使用 indel_generate(operation="insertion", min_length=..., max_length=...)。
3. 删除生成
- 作用: 对序列中的每个碱基独立判断是否删除该碱基。
- API:
dnakit.ops.evolution_generate(sequence[必须], augmentations=("deletion",), seed/rng[二选一], delete_frac[可选])。 - 概率:
delete_frac表示每个碱基位置发生删除的概率,范围为0.0~1.0,默认值为0.05。命中后只删除当前位置的一个碱基。
如果只想在整条序列中随机选择一个连续片段并删除一次,可使用 indel_generate(operation="deletion", min_length=..., max_length=...)。
4. 类进化算法操作
evolution_generate() 还支持局部反向互补、易位和整条反向互补。多个候选操作先无放回抽样,再按固定顺序执行:局部反向互补、删除、易位、插入、整条反向互补、突变。逐碱基概率针对各操作执行时的当前序列。
- 完整 API:
dnakit.ops.evolution_generate(sequence[必须], augmentations[可选], max_augmentations[可选], hard_aug[可选], seed[可选], rng[可选], mut_frac[可选], insert_frac[可选], delete_frac[可选], insert_min/insert_max[可选], shift_min/shift_max[可选], invert_min/invert_max[可选], rc_prob[可选])。 - 结果:
EvolutionGenerationResult.sequence是生成序列;steps保存每个操作是否生效及其实际影响长度;结果同时保存随机源、随机状态和dnakit-evoaug-v3算法版本。 - 抽样规则:
hard_aug=True时每条序列恰好选择max_augmentations种操作;False时从 1 到该最大值随机选择。选中某种操作不保证一定命中碱基,例如概率较低且序列较短时可能不产生变化。
| 操作名 | 作用 |
|---|---|
mutation |
每个碱基独立以mut_frac 概率替换 |
insertion |
每个碱基后独立以insert_frac 概率插入随机 DNA |
deletion |
每个碱基独立以delete_frac 概率删除 |
translocation |
随机 roll 序列,交换断点两侧片段顺序 |
inversion |
将连续片段替换为其反向互补序列 |
reverse_complement |
按rc_prob 将整条序列替换为反向互补 |
5. 片段重排 
rearrange_generate() 先用随机断点把序列切成 segment_count 个非空片段,再执行一种重排:
operation |
作用 |
|---|---|
exchange |
随机交换片段顺序,长度不变 |
inversion |
选中一个片段并替换为其反向互补,长度不变 |
duplication |
选中一个片段并在其后复制一份,长度增加 |
- API:
dnakit.ops.rearrange_generate(sequence[必须], operation[可选], segment_count[可选], seed[可选], rng[可选])。 - 结果:
RearrangementResult保存breakpoints、交换permutation或selected_segment,便于复核生成过程。
6. k-mer 随机打乱 
kmer_shuffle() 不直接独立打乱碱基,而是在原序列的 de Bruijn 多重图上随机采样 Euler 路径。因此会精确保持重叠 k-mer 的计数;例如 k=2 保持二联体计数,k=3 保持三联体计数。默认 ensure_different=True,会尝试生成与原序列不同的序列;若计数结构只有唯一重建结果,则抛出明确错误。
- API:
dnakit.ops.kmer_shuffle(sequence[必须], k[可选], seed[可选], rng[可选], ensure_different[可选], max_attempts[可选])。 - 结果:
KmerShuffleResult保存k、原始 k-mer 计数、尝试次数和随机状态。
该实现参考 k-mer 保持打乱的 Euler 路径方法(见 uShuffle 论文);它只保证指定 k 的重叠计数,不代表保持更高阶 k-mer、功能、表达量或实验性质。
7. 多序列重组 / 交叉
crossover() 接收两条等长 DNA 序列和一个单点边界,生成“第一条序列前缀 + 第二条序列后缀”的子代。边界使用 0-based 半开切分位置;省略 position 时必须传 seed 或 random.Random,随机选择一个同时保留两侧碱基的边界。
- API:
dnakit.ops.crossover(first[必须], second[必须], position[可选], seed[可选], rng[可选])。 - 结果:
CrossoverResult.sequence是子代;position、两个亲本长度和随机状态保存在结果中。
该 API 当前是两条等长序列的一点交叉;不同长度、环状、含 Gap、含 IUPAC 模糊碱基的输入会被拒绝。
数据库提供方、Schema 与高级查询
数据查询
使用统一接口查询 NCBI、Ensembl、ENA、ENCODE 和 UCSC 等公共数据库,从而获取 DNA 序列及相关元数据。
本页介绍序列、疾病、表达、物种、通路、药物、文献和 ENCODE 数据的查询。先看离线查找函数和数据库调用示例,各类接口的完整参数已按主题拆分到下方分类页面,也可以从左侧“数据查询”目录展开进入。
dnakit.search 的统一入口返回 QueryResult;dnakit.databases 保留各数据源的返回结构;dnakit.encode 的查询返回 JSON 文本。基因与转录本注释见基因注释,变异和关联研究分别见变异记录与群体频率和GWAS 研究与关联。
list_operations() 中的 450 个操作包括兼容分发入口 execute_tool;另外 5 个目录和调用函数构成 dnakit.databases 的 455 个公开函数。不能把 450 理解为 450 种独立科学算法。
CLI 提供相同的发现入口:
网页也可以直接搜索 gnomad_get_sv_by_region,跳转到对应函数。
需要动态选择函数时,使用参数字典;下面三种调用形式等价,选择一种运行即可:
import dnakit

params = {"id": "BRCA1", "species": "homo_sapiens"}
result = dnakit.databases.call("ensembl_lookup_gene", params)

# 等价形式:
# result = dnakit.databases.execute(
#     {"name": "ensembl_lookup_gene", "arguments": params}
# )
# result = dnakit.databases.execute_tool(
#     tool_name="ensembl_lookup_gene", arguments=params
# )
print(result)
describe() 的 input_schema 是 DNAKit 当前接受的参数约束;config.parameter 保留提供方原参数。生成包装的可选参数默认 None 时通常表示省略该参数,不代表上游服务的默认值也是 None。别名冲突、条件组合、取值范围仍要遵循 Schema。
返回值保留不同提供方的结构,不统一包装为 result["data"]。提供方结果 Schema 是结构参考;新增查询分支、分页截断和真实返回字段还需核对实际结果。call(..., max_result_bytes=...) 控制序列化结果上限,默认 20 MB。错误结果或超限会抛出异常。
不同服务使用不同坐标和基因组版本,不能把一个接口的坐标约定直接套到另一个接口。ChIP-Atlas 的 requires_data、requires_submission 状态说明仍需要数据或提交任务,详见表达与调控接口。
提供方与入口
- 作用: 汇总 DNAKit 可访问的公共数据库,并统一超时、重试、缓存、限速及返回对象,使不同来源的查询结果具有一致的 provenance 和错误处理。
- API:
dnakit.search.SearchConfig(timeout[可选], max_response_bytes[可选], max_records[可选], api_key[可选], email[可选], tool[可选])、dnakit.search.QueryResult。 - 输入: 可选超时时间、最大响应字节数、最大记录数以及 NCBI 联系信息;具体查询条件由后续查询 API 提供。
| 数据来源 | 主要入口 | 用途 |
|---|---|---|
| NCBI Datasets | taxonomy()、assembly()、gene()、virus() |
分类、组装、基因和病毒查询 |
| NCBI Entrez | entrez() 及 project/sample/variant/expression/literature 包装 |
accession、BioProject、BioSample、ClinVar、GEO、PubMed、版本 |
| NCBI BLAST | submit_blast()、identify()、novelty() |
异步相似性、来源线索和远程新颖性检查 |
| Ensembl REST | sequence()、transcripts()、annotation()、variant()、homology() |
坐标序列、转录本、注释、VEP、同源和比较基因组 |
| ENA Portal | reads()、ena_project()、ena_sample() |
Study/Sample/Experiment/Run/Analysis 和公开文件记录 |
| ENCODE Portal | encode_search() |
表观基因组实验和文件记录 |
| UCSC REST/Downloads | ucsc_*() |
染色体、序列、CpG/重复/调控/保守性轨道及文件目录 |
这些入口依据 NCBI Datasets REST API、NCBI E-utilities、Ensembl REST、ENA Portal API、ENCODE REST API 和 UCSC REST API 实现。
按物种、基因和菌株检索序列
dnakit.search.ncbi.entrez(database, term=None, *, organism=None, gene=None, strain=None,
keywords=None, seq_type=None, source="all", retmax=20, retstart=0, config=None)
保留原来的 entrez("nuccore", "查询表达式") 用法,也支持结构化序列条件。
可选条件与 term 通过 AND 组合;organism/gene/strain 为字面值,keywords/term 支持 Entrez 表达式。
结构化过滤适用于 nuccore 和 protein;菌株通过 All Fields 查询,需核对记录中的实际菌株。
import dnakit

result = dnakit.search.ncbi.entrez(
    "nuccore", organism="Escherichia coli", strain="K-12",
    seq_type="complete_genome", retmax=3,
)
accessions = dnakit.search.ncbi.accessions(result.metadata["uids"])
print(result.total_count, accessions)
for summary in result.records:
    print(summary)
seq_type 支持 complete_genome/genomic/mrna/ncrna/refseq/protein;蛋白序列使用
database="protein"。source="refseq" 可与分子类型组合;source="genbank" 排除 RefSeq,
不代表实验验证等级。空结果不会自动扩大查询。
accessions(uids, *, database="nuccore", config=None) 每批最多解析 200 个 UID,
按输入顺序返回版本化 accession 元组,保留重复项;空输入返回空元组,不发请求;缺失 UID 报错。
accession(identifier) 仍用于查询一个 accession 的摘要。
QueryResult.records 是摘要,metadata["uids"] 是 UID,total_count 是总命中数;
metadata["warnings"] 保留 NCBI 的查询提示。这里不返回原始序列,文件下载见
按 accession 下载序列。
MCP 中的对应名称为 dnakit.search.entrez 和 dnakit.search.accessions,
新增参数会出现在工具描述的输入 Schema 中。
批量数据库查询进度
批量 Ensembl 序列查询支持进度回调。下面使用项目已有的 Rich 依赖显示进度条:
from rich.progress import Progress

from dnakit.search import sequence

regions = ("1:0-100", "2:0-100", "X:0-100")
with Progress() as bar:
    task = bar.add_task("查询 Ensembl", total=len(regions))

    def update(event):
        bar.update(task, completed=event.completed, description=event.item)

    result = sequence("human", regions, progress=update)
trim、delete 与 subsequence 的区别
与任意区间操作的区别
| 需求 | 应使用的 API |
|---|---|
| 从序列左右两端删除碱基 | trim(dna, left=..., right=...) |
| 删除序列中任意一段区间 | delete(dna, start, end) |
| 只保留序列中任意一段区间 | subsequence(dna, start, end) |
trim() 专指两端修剪;任意内部位置的删除属于序列编辑,由 delete() 处理。
命令行验证
- 命令行: 原始文本命令仍会先标准化,再调用统一验证逻辑:
标准化参数
- 核心 args:
keep_ambiguous=True:保留RYSWKMBDHVN模糊碱基;设为False时删除。keep_u=False:默认删除U;设为True时保留。keep_other=False:默认删除除A/C/G/T、IUPAC 模糊碱基和U之外的其他字符;设为True时保留。- 默认行为: 保留模糊碱基,删除
U和其他非 DNA 字符。
兼容入口:01_core_objects
-
高级兼容对象:
dnakit.DNASequence(parts[必须], alphabet[可选], topology[可选], strandedness[可选])。 -
高级兼容对象:
dnakit.DNARecord(sequence[必须], id[必须], ...)。 -
高级兼容对象:
dnakit.DNASet(...)、DNASet.from_records(...)、DNASet.from_sequences(...)和read_set(...)。 -
高级兼容对象:
dnakit.DNAFeature(...)、dnakit.Interval(...);复合或未解析位置使用CompoundLocation、UnresolvedLocation。
兼容入口:02_io_data
- 兼容 API:
read_one()、read_set()仍可用,但新代码不需要记住这两个名称。
兼容入口:04_ops_008_circular_sequence_operations
- 高级序列值 API:
dnakit.ops.circular_subsequence(sequence[必须], start[必须], end[必须], allow_gaps[可选])。
指纹术语
-
特点: 功能上最接近分子中的 Morgan/ECFP 位指纹;无论
k多大,输出长度始终为n_bits。 -
特点: 类似分子中的 MACCS Keys,位含义明确,适合检测已知 motif、启动子模式或酶切识别序列。
Levenshtein 评价:Diversity
- Diversity 的计算方法(平均两两 Levenshtein 距离):
from dnakit import DNARecord, DNASequence, DNASet
from dnakit.evaluation import evaluate_diversity

records = DNASet([
    DNARecord(DNASequence("AAAA"), "a"),
    DNARecord(DNASequence("AAAT"), "b"),
    DNARecord(DNASequence("CCCC"), "c"),
])
report = evaluate_diversity(records)
print(report.metrics["mean_pairwise_levenshtein_distance"])
该值是未归一化的编辑操作数,越大表示集合内部序列差异越大;少于两条序列时公式无定义,返回 None。不同序列长度的数据集不宜直接比较。
Levenshtein 评价:Novelty
- 第二种方法(平均最近参考 Levenshtein 距离):
from dnakit import DNARecord, DNASequence, DNASet
from dnakit.evaluation import (
    ReferenceSearchConfig,
    create_reference_library,
    evaluate_novelty,
)

reference = create_reference_library(
    DNASet([
        DNARecord(DNASequence("AAAA"), "ref-a"),
        DNARecord(DNASequence("CCCC"), "ref-c"),
    ]),
    name="training",
    version="1",
    source="local:example",
)
queries = DNASet([
    DNARecord(DNASequence("AAAA"), "copy"),
    DNARecord(DNASequence("GGGG"), "query-new"),
])
report = evaluate_novelty(
    queries,
    reference,
    config=ReferenceSearchConfig(novelty_calculation="levenshtein"),
)
print(report.metrics["mean_nearest_levenshtein_distance"])
该值是未归一化的编辑操作数,越大表示查询集合离参考集合越远。此模式不使用相似度、coverage 或 copy_threshold;逐条 exact_match 表示最近编辑距离为 0,汇总 exact_match_rate 表示完整序列精确一致的比例。DNAKit 不会自动填充或截断序列。
评价背景 5
-
公式:
||μ_left - μ_right||² + Tr(Σ_left + Σ_right - 2(Σ_left^(1/2) Σ_right Σ_left^(1/2))^(1/2))。实现使用数学等价的样本空间 cross-Gram 核范数,不显式创建高维稠密协方差矩阵。 -
默认模型: Fréchet 评价使用
lucaone、mean pooling 和 L2 归一化。运行标准后端需要安装neural可选依赖,并显式设置RepresentationConfig(allow_remote_code=True)。 -
可选图片:
plot_distance=True保存 Fréchet 距离柱状图,plot_pca=True使用同一批已提取的向量保存 PCA 散点图。两者默认关闭;PNG 文件写入plot_output_dir,路径见报告的parameters["plot_files"]。PCA 是二维展示,距离仍在完整表征空间中计算。图片输出需要bio-plots可选依赖。 -
进度: checkpoint 下载和逐序列表征提取默认显示进度条;可用
RepresentationConfig(show_progress=False)关闭。
评价背景 6
-
DNA 适配: 分子 Frag 使用 BRICS 片段;DNA 没有对应的化学断键规则,因此本实现明确使用 overlapping fixed-length k-mer。默认
k=3、canonical k-mer、忽略含 IUPAC 模糊碱基的窗口。 -
公式:
Σ_f c_generated(f)c_reference(f) / sqrt(Σ_f c_generated(f)² × Σ_f c_reference(f)²)。 -
进度: 默认显示生成集合和参考集合的 k-mer 统计进度;可用
FragmentSimilarityConfig(show_progress=False)关闭。 -
依据:MOSES 对 Frag 的定义。
评价背景 7
-
DNA 适配: 分子 SNN 使用 1024 位、radius 2 Morgan 指纹;本实现默认使用 canonical 7-mer 经 SHA-256 映射得到的 1024 位 DNA 二进制指纹,并计算等价于二进制 Jaccard 的 Tanimoto 相似度。
-
公式:
mean_g max_r Tanimoto(fp(g), fp(r));该指标以生成集合为查询,因此通常不对称。 -
进度: 默认显示两组指纹构建和最近邻扫描进度;可用
SNNConfig(show_progress=False)关闭。 -
依据:MOSES 对 SNN 的定义。